文字列
REGEXEXTRACT関数の使い方・読み方
読み方:REGEXEXTRACT は「レジェックスエクストラクト」と読みます。(一般的な読み方です。公式に読み仮名の定めはありません)
REGEXEXTRACTは、正規表現を使って、文字列から必要な部分だけを取り出す関数です。
このページの中身(21項目)
この記事の書式と対応環境の出どころ(2026-08-26 確認)
- Google スプレッドシート ヘルプ:公式の書式は
REGEXEXTRACT(テキスト, 正規表現)
https://support.google.com/docs/answer/3098244 - Microsoft サポート:REGEXEXTRACT 関数(Microsoft 365 以降で使えます)
https://support.microsoft.com/ja-jp/excel/functions/regexextract-function
関数の仕様は追加・変更されることがあります。書式が合わないときは、上の公式ページで最新をご確認ください。
LEFT や MID が「位置」で切り出すのに対し、REGEXEXTRACTは「パターン」で切り出します。 位置が可変のデータでは圧倒的に短く書けます。
Excelにはありません。 スプレッドシート固有の関数です。
書式
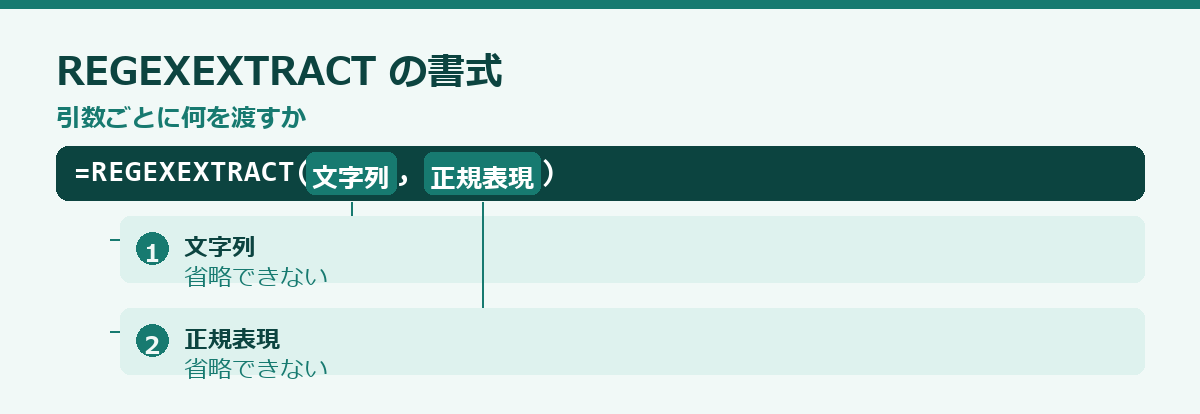
=REGEXEXTRACT(文字列, 正規表現)正規表現は " で囲みます。
正規表現の最小限の知識
実務で使うのは、だいたいこれだけです。
| 記号 | 意味 | |
|---|---|---|
\d | 数字1文字 | |
\D | 数字以外1文字 | |
\w | 英数字とアンダースコア1文字 | |
\s | 空白1文字 | |
. | 任意の1文字 | |
+ | 直前を1回以上 | |
* | 直前を0回以上 | |
? | 直前を0回か1回 | |
{3} | 直前をちょうど3回 | |
[abc] | a か b か c | |
[^abc] | a b c 以外 | |
^ | 先頭 | |
$ | 末尾 | |
(...) | 取り出す範囲 | |
| `\ | ` | または |
() が最重要です
REGEXEXTRACTは、括弧で囲んだ部分だけを返します。括弧がなければ、一致した全体を返します。
. ( ) - などを文字そのものとして扱いたいときは、前に \ を付けます(\. \()。
基本の使い方
A1 = 商品コード:ABC-1234

=REGEXEXTRACT(A1, "\d+")        → 1234
=REGEXEXTRACT(A1, "[A-Z]+")     → ABC
=REGEXEXTRACT(A1, "([A-Z]+)-") → ABC3つ目は「大文字の連続の後にハイフンが続く」パターンで、括弧の中(大文字部分)だけを返しています。
実用例
数字だけ取り出す
=REGEXEXTRACT(A1, "\d+")複数箇所に数字があると、最初の1つしか返りません。全部つなげたいなら REGEXREPLACE で数字以外を消します。
=REGEXREPLACE(A1, "\D", "")括弧の中身を取り出す
=REGEXEXTRACT(A1, "\((.+?)\)")\( と \) で括弧そのものを表し、(.+?) で中身を取り出しています。? は「最短一致」で、括弧が複数あるとき最初のペアだけを拾います。
最後の区切りより後ろ
=REGEXEXTRACT(A1, "([^/]+)$")「/ 以外の文字が末尾まで続く部分」=最後の / より後ろです。RIGHT と FIND で書くと非常に長くなる処理が、これだけで済みます。
拡張子を取り出す
=REGEXEXTRACT(A1, "\.([^.]+)$")ドメインを取り出す
=REGEXEXTRACT(A1, "https?://([^/]+)")s? で http と https の両方に対応しています。
メールアドレスのユーザー名部分
=REGEXEXTRACT(A1, "^([^@]+)@")日付を取り出す
=REGEXEXTRACT(A1, "\d{4}[-/]\d{1,2}[-/]\d{1,2}")[-/] でハイフンとスラッシュの両方に対応、{1,2} で1桁も2桁も許容しています。
郵便番号を取り出す
=REGEXEXTRACT(A1, "\d{3}-?\d{4}")複数の部分を同時に取り出す
括弧を複数書くと、横方向に複数の結果が返ります。
=REGEXEXTRACT(A1, "([A-Z]+)-(\d+)")ABC と 1234 が2つのセルに展開されます。右隣を空けておいてください。
1つだけ欲しいなら INDEX で選びます。
=INDEX(REGEXEXTRACT(A1, "([A-Z]+)-(\d+)"), 1, 2)全行に適用する
ARRAYFORMULA が確実に効きます。ここが SPLIT に対する大きな利点です。
=ARRAYFORMULA(IF(A2:A="", "", REGEXEXTRACT(A2:A, "\d+")))一致しない行があるとエラーになるので、IFERROR を挟みます。
=ARRAYFORMULA(IF(A2:A="", "", IFERROR(REGEXEXTRACT(A2:A, "\d+"), "")))この形が実用上の基本形です。
REGEXMATCH・REGEXREPLACEとの使い分け
| 関数 | 用途 |
|---|---|
| REGEXEXTRACT | 取り出す |
REGEXMATCH | 一致するか判定する(TRUE/FALSE) |
REGEXREPLACE | 置き換える |
判定なら REGEXMATCH です。
=IF(REGEXMATCH(A1, "^\d{3}-\d{4}$"), "OK", "形式エラー")FILTER の条件にも使えます。
=FILTER(A:C, REGEXMATCH(B:B, "東京|大阪"))エラーの対処
#N/A が出る
パターンに一致しませんでした。 これが最も多いエラーです。
- 全角と半角が違う(
ーと-) - 対象に想定外の文字が入っている
- パターンの書き間違い
IFERROR で包むのが基本ですが、包む前に一致しない行を確認してください。 データの想定違いに気づくきっかけになります。
=IFERROR(REGEXEXTRACT(A1, "\d+"), "パターン外")「パターン外」と表示しておけば、後で確認できます。
想定と違う部分が返る
- 括弧の位置が違う。取り出したい部分だけを
()で囲んでください +が貪欲に一致しすぎている。+?で最短一致にしてください
#REF! が出る
複数の括弧を書いた結果の展開先に、データが入っています。
位置で取れないものを取り出す
文字列から一部を取り出す方法には、位置で指定する方法とパターンで指定する方法があります。位置で取れるのは、桁数や区切りが決まっている場合だけです。それ以外は、パターンで指定するしかありません。
たとえば、自由記述の文章の中から電話番号らしき部分を取り出したいとします。位置は決まっていません。しかし「数字とハイフンの並び」という形は決まっています。この形を指定して取り出すのが、正規表現の役割です。
同じように、文章の中の数字だけを取り出す、カッコで囲まれた部分を取り出す、アルファベットで始まるコードを取り出す。いずれも位置ではなく形で決まる要求です。
位置で取り出す関数を組み合わせて似たことをやろうとすると、条件分岐が増えて数式が破綻します。パターンで書けば、一つの数式で済みます。この使い分けができると、文字列処理の守備範囲が大きく広がります。
最小限のパターンから覚える
正規表現は覚えることが多く見えますが、実務で使うのは限られた記号だけです。まず次の五つを押さえてください。
数字を表す記号があります。これを繰り返しの記号と組み合わせれば、連続した数字を取り出せます。
任意の一文字を表す記号があります。何でもよい位置に使います。
繰り返しを表す記号が二種類あります。零回以上と一回以上です。この違いは、その部分が無くてもよいかどうかです。
回数を指定する書き方があります。ちょうど三回、三回から五回、といった指定ができます。桁数が決まっているコードを取り出すときに使います。
いずれかを表す書き方があります。角括弧の中に候補を並べる形です。
この五つで、実務の要求の大半は書けます。すべてを覚える必要はありません。必要になったときに調べればよく、よく使うものだけを手元に控えておけば足ります。
括弧で取り出す部分を指定する
正規表現には、一致した全体のうち、どの部分を取り出すかを指定する仕組みがあります。丸括弧で囲んだ部分が、取り出す対象になります。
たとえば「注文番号:A-1234」という文字列から、番号の部分だけが欲しいとします。「注文番号:」の後ろに続く形を指定しつつ、取り出すのは番号だけ、という指定ができます。
この仕組みを使うと、目印になる文字を含めてパターンを書けます。目印があることで誤って別の部分に一致する危険が減り、取り出す範囲は正確に指定できます。
括弧が複数ある場合、どれを取り出すかを指定する必要があります。環境によって扱いが違うので、複数の括弧を使うときは動作を確認してください。単純な用途なら、括弧は一つにしておくのが安全です。
なお、一致しない場合はエラーが返ります。すべての行に対象が含まれているとは限らないので、エラー時の処理を書いておくのが実務的です。
使いすぎないという判断
正規表現は強力ですが、万能ではありません。使うべきでない場面もあります。
第一に、単純な位置の切り出しで足りる場合です。固定長のコードから桁を取り出すだけなら、位置で指定するほうが読みやすく、意図も明確です。
第二に、他の人が触るファイルの場合です。正規表現は読み手を選びます。数式を見ても何をしているか分からず、修正もできない状態になりがちです。使うなら、近くに何をしているかの説明を残してください。
第三に、パターンが複雑になりすぎる場合です。条件が増えるほど、意図しない部分に一致する危険が高まります。テストしていない入力で誤動作すると、原因の特定に時間がかかります。
第四に、環境の互換性です。正規表現を使う関数はスプレッドシート特有のものが多く、他の環境では動きません。ファイルを移す予定があるなら避けてください。
これらを踏まえたうえで、位置では書けない要求にだけ使う。この線引きができていれば、正規表現は非常に役に立つ道具になります。
抽出できたかを確認する仕組み
パターンによる抽出は、一致しなかったときにエラーを返します。これを回避の関数で包むと、抽出できなかったことが見えなくなります。
推奨は、抽出の結果とは別に、一致したかどうかを判定する列を持つことです。一致を判定する関数で真偽値を出しておけば、抽出できた件数が数えられます。
想定される件数と一致するかを確認してください。全行から抽出できるはずなのに一部しか一致していなければ、パターンが狭すぎるか、データに例外が混ざっています。
一致しなかった行だけを抽出して確認する仕組みも有効です。どういうデータで失敗しているかが分かれば、パターンを直すべきか、そのデータ自体が異常なのかを判断できます。
抽出できた値の種類を数える方法もあります。想定される種類より多ければ、意図しない部分に一致しています。重複を除く関数で一覧を出せば、異常な値が見つかります。
これらの確認は、作業列を数本足すだけで済みます。パターンによる処理は間違いに気づきにくいので、確認の仕組みは必須だと考えてください。
自動化する前に、実データの一部で必ず確認する。この手順を飛ばすと、静かに間違ったまま運用することになります。
「文字列」の関数を全体から見る
文字列に含まれる関数を、全体から見ておきます。同じカテゴリの関数は、つまずく場所も似ています。この記事のほかに31本あります。
| 記事 |
|---|
| CHAR |
| CLEAN |
| CODE |
| CONCAT |
| CONCATENATE |
| EXACT |
| FIND |
| FIXED |
| HYPERLINK |
| IMAGE |
| JIS |
| LEFT |
| LEN |
| LENB |
| LOWER |
| MID |
| NUMBERVALUE |
| PROPER |
| REGEXMATCH |
| REGEXREPLACE |
| REPLACE |
| REPT |
| RIGHT |
| SEARCH |
| SPLIT |
| SUBSTITUTE |
| TEXT |
| TEXTJOIN |
| TRIM |
| UPPER |
| VALUE |
このカテゴリで共通するつまずき
全角と半角、前後の空白、改行。この3つが原因のほとんどです。1つで理解した内容は、同じカテゴリの他の関数にもそのまま使えます。
どれを使うかの決め方
位置で取るのか、記号を目印に取るのかで使う関数が変わります。関数の一覧を眺めて選ぼうとすると、どれも当てはまるように見えて決まりません。
迷ったときは
→ 全関数の一覧 に目的別の索引があります。
数式を書く前の手順
手順を分けると、どこで詰まっているかが分かります。
1. 出したい結果を一文で書く
「何を、どの条件で、どんな形で出したいか」。この一文が書ければ、関数はほぼ決まります。書けないなら、まだ要件が固まっていません。
2. 元データの型を確認する
全角と半角、前後の空白、改行。この3つが原因のほとんどです。=ISNUMBER(A2) で数値かどうかを確認できます。見た目が同じでも、数値と文字列は別物です。
3. 空欄と0の扱いを決める
未入力なのか、実績が0なのか。表の意味が変わります。どちらとして扱うかを決めてから書いてください。
4. 条件の数を数える
位置で取るのか、記号を目印に取るのかで使う関数が変わります。将来条件が増える可能性があるなら、最初から複数条件に対応する形にしてください。
5. 共有先の環境を確認する
新しい関数は、古い環境で開くとエラーになります。社外に渡すファイルでは、この一点で選択肢が変わります。
6. 1行だけ書いて確認する
全行にコピーする前に、1行分の結果が正しいかを見てください。間違ったまま広げると、直す手間が増えます。
どの関数でも共通する確認
以下は、どの関数を使っていても同じです。
参照を固定したか
下方向にコピーする数式では、動いてはいけない参照を固定します。上の数行だけ見て判断しないでください。ずれは下のほうで表面化します。
範囲の行数が揃っているか
複数の範囲を渡す関数では、行数がずれると結果が狂います。エラーにならず値が返るため、気づきにくい種類の間違いです。
型が揃っているか
=ISNUMBER(A2)数値として入っているかを判定します。システムから書き出したデータでは、これが原因のことが多くあります。
前後に空白が入っていないか
=LEN(A2)&" / "&LEN(TRIM(A2))数が違えば、余分な空白が入っています。見た目では判別できません。
別の方法で検算したか
同じ数字を別の関数でも出して、突き合わせてください。1つの結果だけを見ても、正しいかどうかは判断できません。
最終行まで確認したか
一番下までスクロールして、結果を見てください。途中から値が変わっていないかを確認します。
引き継ぐときに残すこと
数式は動いていても、意図は残りません。渡す前に、次の点をシート内にメモしてください。3分で終わります。
何を出している数式か
一行で構いません。読めば分かると思っても、数か月後の自分には分かりません。
どの表を参照しているか
参照先のシート名と、更新の担当。別ファイルなら、その場所も書いてください。
該当しないときの扱い
空欄にしているのか、文言を出しているのか、エラーのまま残しているのか。書いていないと、受け取った側は空欄をデータなしと読みます。
触ってはいけない場所
列を挿入すると壊れる数式がある場合、必ず書き残してください。この一行があるだけで、引き継ぎ後の事故が大きく減ります。
使った関数の対応環境
新しい関数を使っている場合、古い環境では開けません。共有の範囲が広がる可能性があるなら、明記してください。
確定した期間は値にする
締めた月の集計は、値貼り付けにしてください。参照元を消しても壊れなくなり、ファイルも軽くなります。
このサイトの収録状況
全201本を、次のカテゴリに分けて収録しています。
| カテゴリ | 記事数 |
|---|---|
| 目的別 | 51本 |
| 集計 | 47本 |
| 文字列 | 31本 ←この記事 |
| 日付 | 19本 |
| 検索・参照 | 15本 |
| 条件 | 15本 |
| 機能 | 12本 |
| 配列・抽出 | 10本 |
| 関数一覧 | 1本 |
探し方の順番
関数名が分かっているなら検索窓から。やりたいことだけ決まっているなら「目的別」から。近い関数を比べたいなら、同じカテゴリの一覧から入ってください。
記事の構成
どの記事も、書式・実例・つまずきやすいところ・似た関数との使い分けを同じ順番で並べています。1本読めば、他の記事も同じ場所を探せます。
よくある質問
Q. 一致しないとエラーになります
エラー回避の関数で包むか、一致するかどうかを先に判定してください。
Q. 複数の一致を全部取り出せますか
この関数は最初の一致だけを返します。すべてを取り出したい場合は、別の方法が必要です。
Q. 大文字と小文字は区別されますか
区別されます。区別しない指定を先頭に置く書き方もありますが、環境によって対応が違います。
Q. 日本語も扱えますか
扱えます。ただし文字の範囲を指定する書き方は、環境によって挙動が変わることがあります。
Q. 数字だけを取り出したいのですが
数字を表す記号と繰り返しの記号を組み合わせてください。連続した数字が取れます。
Q. パターンが合っているか確認したいのですが
一致するかどうかを判定する関数があります。取り出す前に、まずそれで確認すると早く原因が分かります。
Q. Excelでも使えますか
スプレッドシート特有の関数です。他の環境では、位置で切り出す関数の組み合わせで代替してください。
Q. 置き換えもできますか
正規表現で置き換える関数があります。→ REGEXREPLACE関数の使い方
まとめ
- 書式は
=REGEXEXTRACT(文字列, "正規表現") ()で囲んだ部分が返る。囲まなければ一致部分全体- 覚えるのは
\d+[]^$()?くらいで足りる - 位置が可変のデータでは MID より圧倒的に短い
- 全行適用は ARRAYFORMULA + IFERROR が基本形
- 判定は
REGEXMATCH、置換はREGEXREPLACE
関連する関数
- SPLIT — 区切り文字で分割する
- MID — 位置で切り出す
- SUBSTITUTE — 文字を置き換える
- FILTER —
REGEXMATCHと組み合わせて絞り込む - 関数一覧に戻る